本メディアはAI活用の情報メディアで、株式会社S.Lineが運営しています。記事内で当社サービスに触れる場合は「当社」と明記します。 運営会社の情報
METR評価とは、Anthropic社内でAIの研究開発がどれだけ速まっているかを、外部の評価者が調べた報告のことです。
結論は「約2倍。ただし幅が広く、証拠の大半は非公開」です。出典は、2026年11月5日に公開されたMETRの評価報告です。
この記事は、2026年11月9日に報告の本文を開いて確認できた内容だけで書いています。
- 「約2倍」が何の速さを指すのか
- 1.3倍から3倍という幅の意味
- 非公開の証拠があることを、どう読むか
- AIを仕事に使う個人が、このニュースをどう扱うか
この記事の読者向け・無料
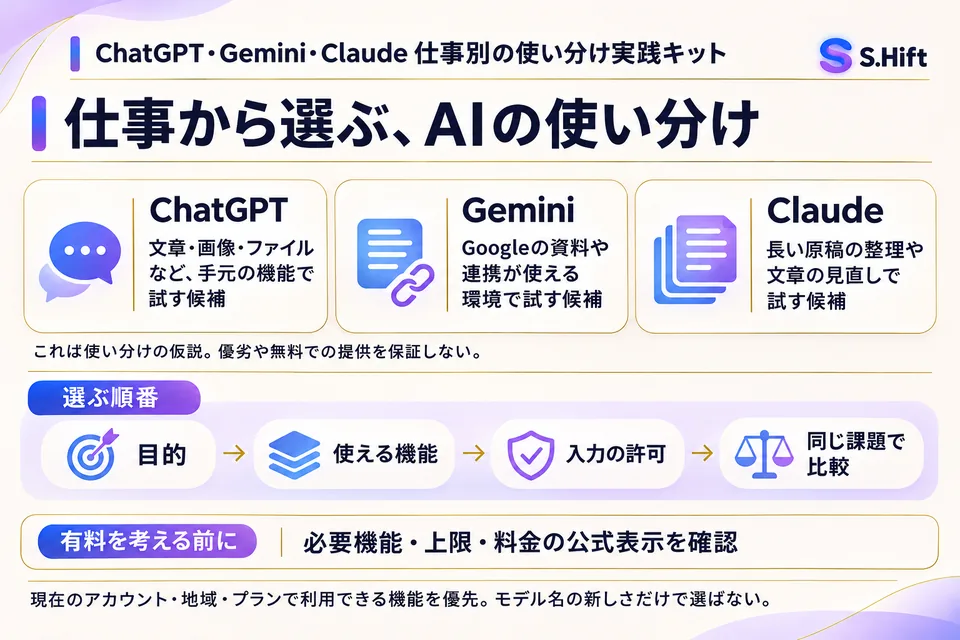
ChatGPT・Gemini・Claude 仕事別の使い分け実践キット
中身
- ChatGPT・Gemini・Claude を仕事別に選ぶ表
- 目的→機能→入力の許可→比較の順番
- 有料プランを考える前の確認
- 下のボタンから LINE を友だち追加
- トークで「AIの使い分け」と送る
- ChatGPT・Gemini・Claude 仕事別の使い分け実践キットが自動で届きます
友だち追加は無料です。届いた後はいつでもブロックできます。
LINEで「AIの使い分け」を受け取るMETRの評価とは何か|誰が何を調べたのか
METRの評価は、2026年8月12日から10月29日まで、METRのスタッフがAnthropicの社内データを高いアクセス権で確認し、AIがAI研究開発をどれだけ加速しているかを見積もったものです。
報告によると、Anthropicは社内の研究開発の指標や、モデルのベンチマークの点数などを提供しました。出典はMETRの評価報告です。
対象はAnthropic一社です。他の企業は、この報告の結論に含まれていません。
報酬については、同じ報告に、METRはAnthropicから支払いを受けていないと書かれています。
結論は「約2倍」|何の速さが2倍なのか
約2倍とは、Anthropicがモデルの能力を高めるペースが、2024年3月から2025年10月の間の約2倍になっているという見立てで、対象は内容がはっきり定まった課題です。
報告は、2026年10月時点で、評価基準を決めやすい課題におけるモデルの能力向上が、その期間のペースの約2倍だろうとしています。出典はMETRの評価報告です。
この見積もりは「高い不確実性」付きで、真の値が1.3倍や3倍に近くても驚かないと、同じ報告に書かれています。
| 項目 | 報告の記載 | 読むときの注意 |
|---|---|---|
| 中心的な見立て | 2024年3月〜2025年10月のペースの約2倍 | 課題が明確に定まったものでの能力向上 |
| 幅の目安 | 1.3倍または3倍に近くても驚かない | 評価者が示した見方の幅 |
| ベンチマーク上の数字(AECI) | 2025年10月以前のペースの1.9倍(95%信頼区間は1.5〜2.8倍) | AECIはAnthropic版のEpoch Capabilities Index |
| 訓練計算量 | 加速の原因は、訓練計算量の伸びの加速ではないと確信している | 計算資源を増やしたから、という説明ではない |
表の数字はいずれもMETRの評価報告の記載です。
「2倍」を年数に直すと|加速の読み方
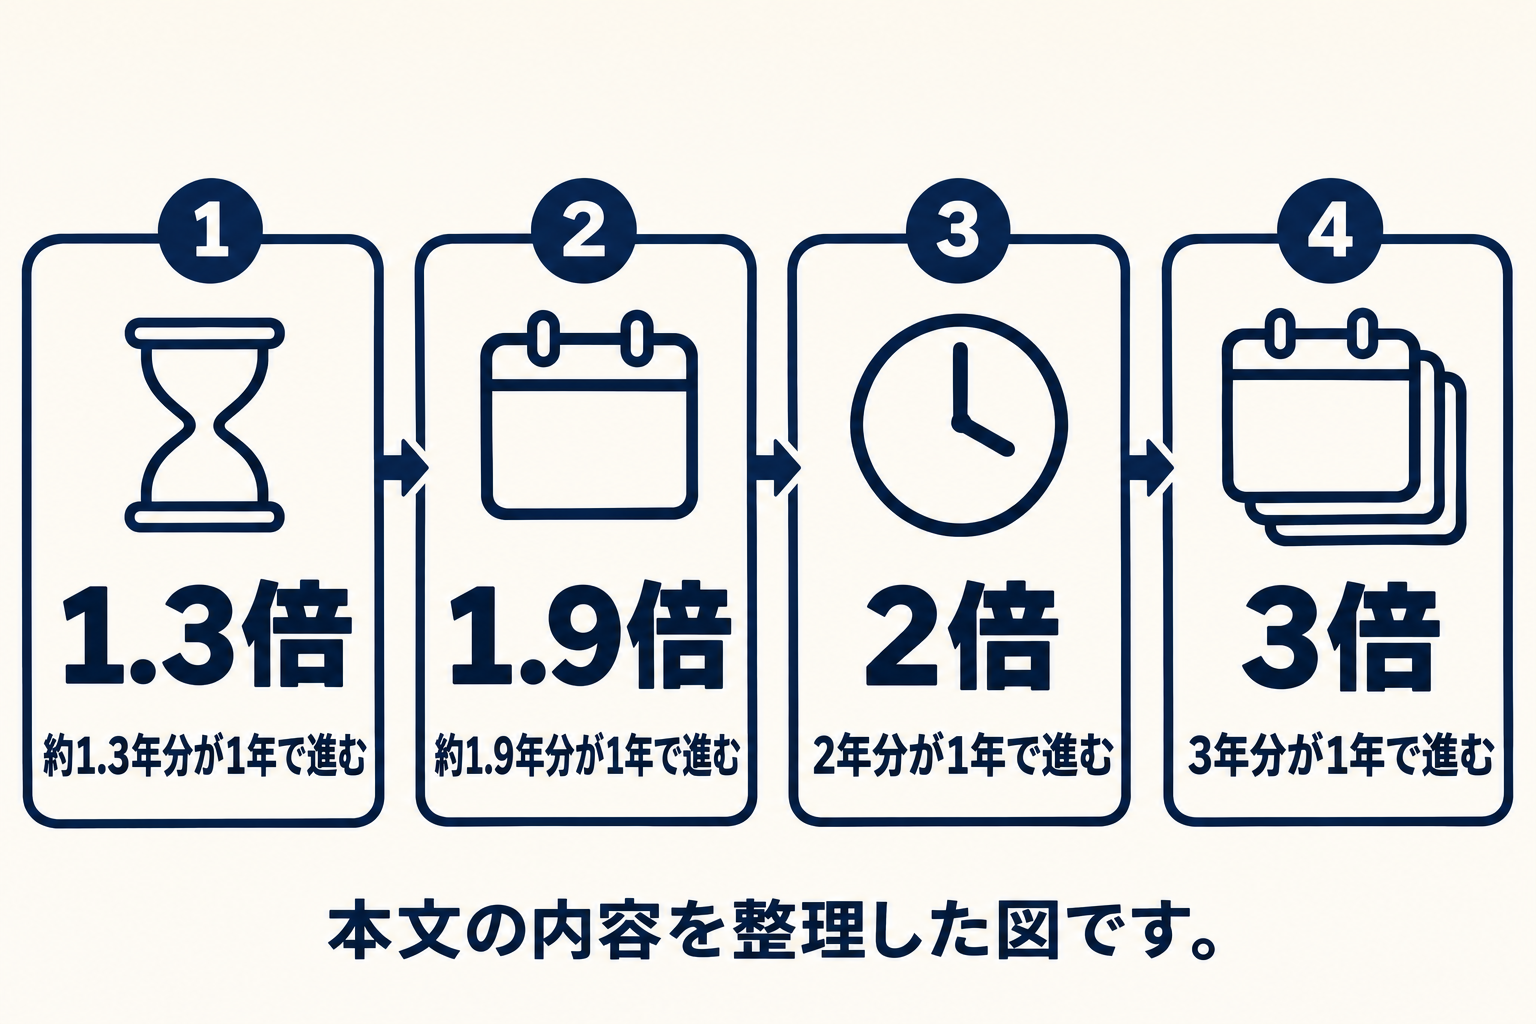
METRの定義では、加速が2倍とは、過去のペースで2年かかる進歩が1年で起きることを指します。
報告の例では、過去の傾向が年15ポイントの指標が年30ポイントになると、加速は2です。出典はMETRの評価報告です。
この定義を各倍率に当てはめた換算が、次の表です。表の右列は、この記事の計算です。
| 加速の倍率 | 報告での位置づけ | 過去ペースで何年分が1年で進むか(記事の計算) |
|---|---|---|
| 1.3倍 | 幅の下側の目安 | 約1.3年分 |
| 1.9倍 | AECIの推定値 | 約1.9年分 |
| 2倍 | 中心的な見立て | 2年分 |
| 3倍 | 幅の上側の目安 | 3年分 |
報告は、AECIの結果について、Anthropicが直近1年で進めた分は、2023年10月から2025年10月までの進歩と同じ程度に見えると述べています。
この換算で分かるのは、幅が広いと「1年で進む量」が1.3年分から3年分まで変わる、という点です。
言えることと言えないこと
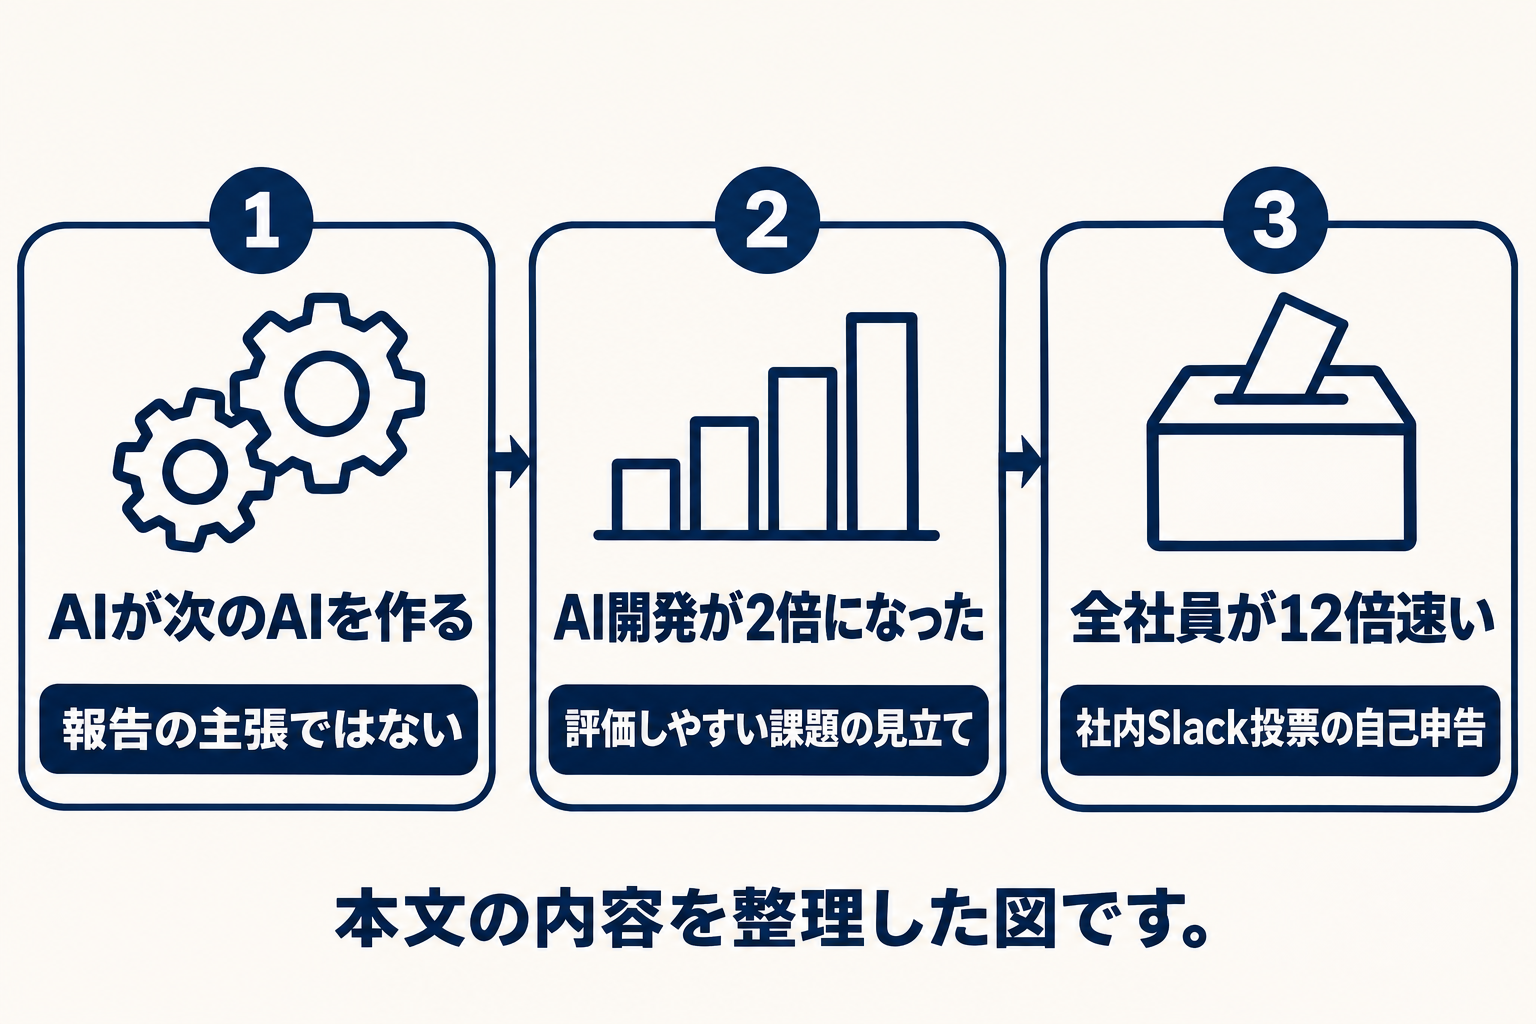
この報告から言えるのは、Anthropicのモデルの能力向上が速まっているという見立てまでです。加速の多くはAIの利用によると考えられていますが、確定ではありません。
加速の原因について、報告は、現在の加速の過半はAIを研究開発に広く使っていることによると考えられるとしています。同時に、不確実性は大きく、2025年後半の加速には他の要因も大きく関わったと書いています。出典はMETRの評価報告です。
| 見出しにしやすい言い方 | 報告から言えること |
|---|---|
| AIが自分で次のAIを作っている | この言い方は報告の主張ではない。研究開発は主にAIの支援で速まっており、完全に自律した貢献はまだ重要部分に達していないと、Anthropic側から説明を受けたと書かれている |
| AI開発が2倍になった | 報告が述べるのは、評価しやすい課題でのモデルの能力向上のペースの見立て。広く内容が曖昧な課題への当てはまり方には、追加の不確実性があるとしている |
| 全社員の作業が12倍速くなった | 12倍は、社内のSlackの簡易投票での自己申告で、報告は非常に緩い証拠と位置づけ、個人の効率向上は加速の倍率とは対応しないとしている |
完全な自律については、研究者が「signs of life(兆し)」を挙げる一方で、現時点の研究開発は主にAIの支援によるもの、というのが報告の書き方です。
証拠の大半が非公開|どう読めばよいか
Anthropicは、METRが結論の根拠として最も有益だと考えた証拠の大半を伏せたため、外部の読者は報告の結論を自分で検証しにくい状態です。
報告は、伏せた理由についてAnthropicが他のAI開発者の加速につながりうる機密情報を取り除くためと説明したと書いています。出典はMETRの評価報告です。
METR自身も、そのため一般の読者はMETRの判断に頼る度合いが理想より大きくなる、と認めています。
報告は、評価の弱点も挙げています。
- データの多くを、Anthropicの技術職員2人を通じて受け取った
- 分析の大半でClaudeを使っており、見え方がゆがむ可能性が原理上ある(ただしMETRは、人への聞き取りと照合しても系統的なずれは見つからず、大きなリスクではないと考えている)
- 研究を妨げる要因(ボトルネック)の見方が何度か変わったため、その点の現在の評価に自信がない
こうした点を差し引くと、この報告は「確定した事実」ではなく「評価者の判断つきの見積もり」と読むのが妥当です。
実践用の「ChatGPT・Gemini・Claude 仕事別の使い分け実践キット」を無料で配布しています。LINE で「AIの使い分け」と送ると届きます。LINEで受け取る
見積もりが上振れ・下振れする理由
METRは、加速が見積もりより高くなる理由と低くなる理由を、それぞれ挙げています。
低くなりうる理由は、非AI要因を十分に重く見ていなかった場合と、加速が評価しやすい課題に限られる場合です。
高くなりうる理由は、成長が加速し続けている場合と、自動化が想定より近い場合です。出典はMETRの評価報告です。
| 方向 | 報告が挙げる理由 |
|---|---|
| 見積もりより低い | 非AI要因を十分に重く見ていなかった/加速が「評価しやすい課題」に限られる/過去(2023〜2025年)の成長率が例外的に低かった |
| 見積もりより高い | 成長が加速し続けている(双曲線的な成長)/自動化が近い/ベンチマークが実世界の影響を過小評価している |
| どちらとも言えない点 | モデルの結果は訓練後にしか観測できず、研究開発の実際の加速は訓練時間ぶん遅れて見える |
どちらの方向の理由も並べられているため、約2倍という数字は、ひとつの目安として扱うのが適切です。
AIを仕事に使う個人はどう受け取るか|ツールの見直し周期
この報告は、あなたが使うAIの性能が何倍になるかを測ったものではないため、結論は「使い方の見直し周期を決めておく」といった一般的な備えにとどめるのが現実的です。
報告が測っているのは、Anthropic社内の研究開発の速さに関する見積もりです。利用者の作業時間や成果の変化は、対象に入っていません。
一方で、AIの機能や制限は更新で変わります。そのため、使っているAIの公式の更新情報を見る日を、あらかじめ決めておく方法があります。
- よく使うプロンプトを3本ほど選ぶ
- 決めた日に、同じ入力で実行して出力を保存する
- 前回との差を、使える・直す・やめる、で分ける
- 差が出た場合だけ、手順書やテンプレートを更新する
仮の例として、毎月第1営業日に上の4つをやる、と決めておく形があります。周期は、更新情報の量や仕事の重要度に合わせて変えられます。
AIの出力を仕事で使う前の確認方法は、AIハルシネーション対策のファクトチェック手順にまとめています。
導入の効果を自社で記録して確かめる方法は、生成AIの導入効果を社内で評価する方法が参考になります。
調査や報告の数字を読むときの確認点
数字つきのニュースは、「何の速さか」「誰が測ったか」「証拠は公開されているか」の3点を先に確かめると、見出しだけで判断しにくくなります。
- 対象は何か(今回はAnthropic社内の、評価しやすい課題)
- 幅はどのくらいか(今回は1.3倍〜3倍)
- 証拠は公開されているか(今回は大半が非公開)
- 見出しの言い回しは、本文と一致しているか
調査結果の読み方の例は、Stack Overflow 2026調査の読み方でも扱っています。
AIが道具を使って作業を進める仕組みの基本は、AIエージェントの解説記事が入口になります。
よくある質問(FAQ)
- Q1. METRの評価では、何が調べられたのですか。
- 2026年8月12日から10月29日にかけて、METRのスタッフがAnthropicの社内データを確認し、AIによる研究開発の加速を見積もりました。出典はMETRの評価報告です。
- Q2. 「AIが自分で次のAIを作っている」ということですか。
- そう断定する根拠は、この報告にはありません。報告は、研究開発は主にAIの支援で速まっており、完全に自律した貢献が大きな割合を占める段階ではないと、Anthropic側から説明を受けたと書いています。
- Q3. 「2倍」は確定した数字ですか。
- 確定した数字ではありません。報告は高い不確実性を明記し、1.3倍や3倍に近くても驚かないとしています。
- Q4. 証拠が非公開なのに、信じてよいのでしょうか。
- 外部から検証しにくいのは事実で、METR自身も一般の読者がMETRの判断に頼る度合いが大きくなると認めています。信じるか疑うかを急いで決めず、「評価者の判断つきの見積もり」として保留するのが無理のない読み方です。
- Q5. 仕事でAIを使う個人は、何を変えるべきですか。
- この報告だけで変えるべきことは決まりません。使っているAIの更新情報を確認する周期を決めておくと、変化に気づきやすくなります。
読み終わったら、手元に残す
ChatGPT・Gemini・Claude 仕事別の使い分け実践キット
中身
- ChatGPT・Gemini・Claude を仕事別に選ぶ表
- 目的→機能→入力の許可→比較の順番
- 有料プランを考える前の確認
LINE を友だち追加して「AIの使い分け」と送ると、無料で届きます。
LINEで「AIの使い分け」を受け取るまとめ
METRの評価は、Anthropic社内のAI研究開発の加速を、評価しやすい課題で約2倍と見積もったものです。
幅は1.3倍から3倍で、証拠の大半は非公開です。
見出しの言葉をそのまま受け取らず、何の速さを、誰が、どの証拠で測ったかを確かめて読みます。
仕事でAIを使う個人は、確定的な予告として扱うより、使うAIの更新を確認する周期を決めておく使い方が現実的です。
AI活用をさらに学びたい方は、受取案内をご確認ください。